FEATURES
Lista permitida, no un drop incompleto
Se excluyeron identificadores y los cinco indicadores de modos de fallo porque introducirían señales no generalizables o leakage.
CASO DE ESTUDIO · RELEASE EDUCATIVO 1.0.1
Machine Failure Risk Classifier es un proyecto individual de machine learning de principio a fin. El objetivo no fue conseguir una cifra llamativa, sino construir un proceso revisable: datos identificados, selección sin leakage, evaluación final única, API estricta y una demo que también sabe abstenerse.
La versión 1.0.1 llevó la interfaz, el contrato API y la documentación pública canónica al inglés. El modelo, el umbral y la evaluación congelada permanecieron sin cambios; el holdout no volvió a abrirse.
01 · RETO
El dataset AI4I 2020 contiene 10.000 observaciones sintéticas y una clase positiva poco frecuente. La tarea es clasificar una observación como fallo o no fallo usando seis variables operativas.
El principal riesgo era construir una demo convincente con evidencia débil: usar columnas que revelan el target, seleccionar el umbral con el conjunto final o destacar una accuracy alta cuando la clase mayoritaria ya alcanza 96,6 %. Por eso el trabajo se centró primero en el contrato de evaluación y después en el modelo.
Es una demostración educativa de ingeniería de machine learning. No predice vida útil restante, causas físicas ni fallos futuros de una máquina real.
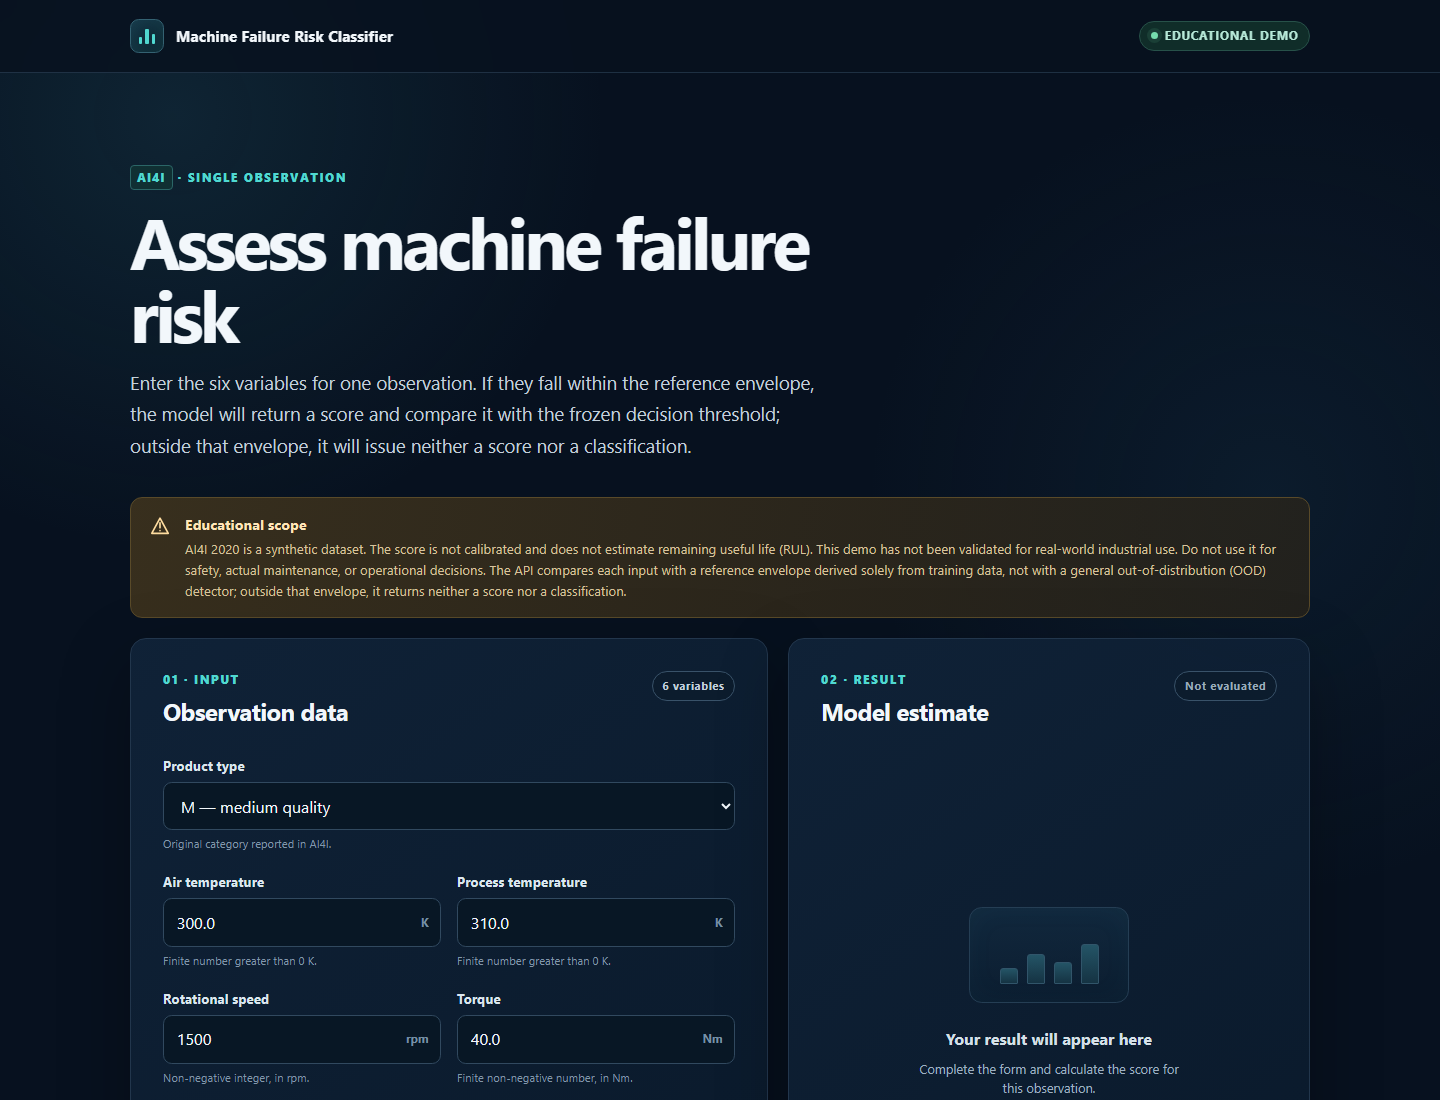
02 · PROCESO
El holdout se materializó antes de la exploración. A partir de ahí, las decisiones de features, modelo y umbral se hicieron solo con las 8.000 filas de training.
Fuente, schema y SHA-256 fijados antes de transformar los datos.
Partición estratificada con el holdout separado antes de la EDA.
Cinco folds, dos baselines y un random forest dentro del mismo contrato de evaluación.
Umbral elegido con predicciones out-of-fold y congelado antes del resultado final.
El workflow ejecutó una evaluación final; el recibo versionado conserva el resultado.
La API valida el artefacto congelado al cargar y se abstiene fuera de la referencia.
FEATURES
Se excluyeron identificadores y los cinco indicadores de modos de fallo porque introducirían señales no generalizables o leakage.
MÉTRICA
La clase positiva es minoritaria. AP permite comparar la calidad del ranking sin esconder el problema detrás de la clase dominante.
MODELO
Dummy, regresión logística y random forest. No hubo una búsqueda extensa de hiperparámetros después de mirar el resultado.
APLICABILIDAD
Si un valor sale de la envolvente marginal observada en training, la API responde sin score ni clasificación.
03 · RESULTADOS
| Candidato | AP media CV | ROC-AUC media |
|---|---|---|
| Dummy prior | 0,033875 | 0,500000 |
| Regresión logística | 0,441433 | 0,899275 |
| Random forest | 0,643812 | 0,969935 |
| Métrica | Resultado | Lectura |
|---|---|---|
| Average Precision | 0,649538 | Métrica principal |
| ROC-AUC | 0,965458 | Métrica complementaria |
| Precision | 0,588235 | 50 aciertos entre 85 alertas |
| Recall | 0,735294 | 50 de 68 fallos detectados |
| F1 | 0,653595 | Con el umbral congelado |
LECTURA PRÁCTICA DEL HOLDOUT
50 fallos detectados · 18 omitidos · 35 falsas alertasLa precision estimada tiene un intervalo Wilson del 95 % de 0,482–0,687 y el recall de 0,620–0,826. Los intervalos reflejan el soporte finito de este holdout; no corrigen el carácter sintético de los datos ni miden incertidumbre por observación.
04 · INGENIERÍA
TRAZABILIDAD
Manifiestos, hashes, run congelado y recibo final conectan datos, selección, modelo y evaluación.
CONTRATO API
FastAPI rechaza campos extra, tipos ambiguos, valores no finitos, claves duplicadas y cuerpos sobredimensionados.
RUNTIME
La aplicación comprueba identidad, hash, versiones, clases y orden de features antes de servir una predicción.
ENTREGA
La release pasa una suite automatizada, CI en Windows/Linux y se ejecuta en un contenedor mínimo con usuario no root.
05 · LÍMITES
PARA USO REAL
Harían falta datos representativos, validación externa y temporal, costos operativos, calibración, monitoreo de deriva y revisión de ingeniería y seguridad.
APRENDIZAJE
La parte más importante no fue entrenar un random forest, sino establecer contratos que hicieran revisables los datos, la selección, el artefacto y cada respuesta de la API.
EVIDENCIA PÚBLICA
La demo permite probar el contrato de inferencia. El repositorio conserva metodología, pruebas, decisiones y resultados versionados.